Uma arquitetura medalhão para testes automatizados
arquitetura de software, experiência de desenvolvimento
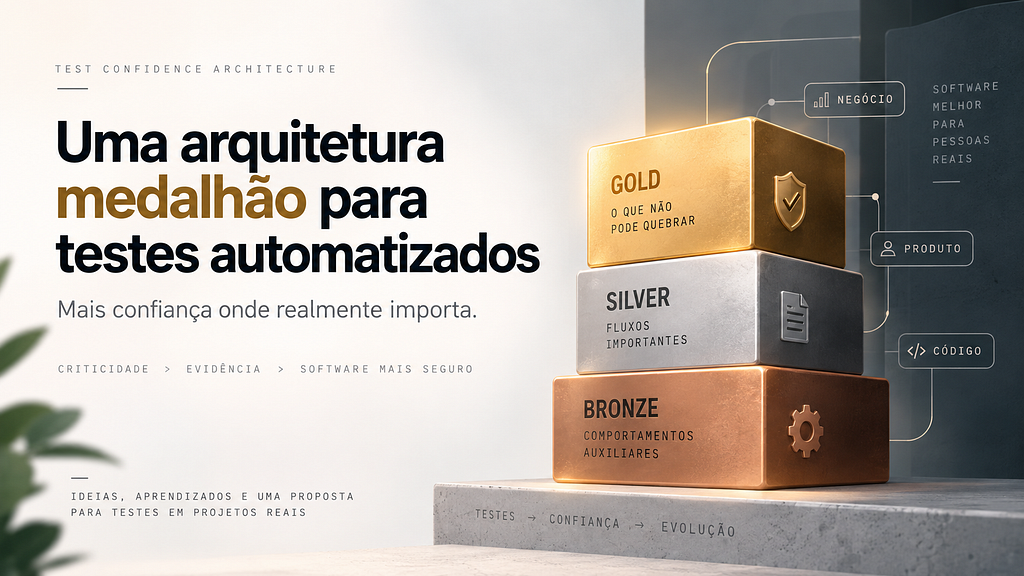
Faz bastante tempo que penso em um plano factível de testes automatizados para software em produção.
Principalmente em startups.
A ideia parece simples: como desenvolver rápido sem abrir mão da segurança?
Existe uma resposta bastante conhecida para isso: a pirâmide de testes.
Já aprendemos que deveríamos ter muitos testes unitários, menos testes de integração e poucos testes End-to-End. A justificativa é conhecida: testes unitários são rápidos, baratos e fáceis de manter, enquanto testes E2E são mais lentos, frágeis e caros.
Mas tenho começado a questionar uma parte dessa premissa.
Será que essa diferença de custo ainda é tão grande?
A pirâmide ainda faz sentido?
Gosto muito das ideias do Rafael Ponte sobre testes, principalmente quando ele fala sobre o equilíbrio entre testes unitários, integração e E2E.
Em uma de suas palestras, “Por que testes de unidade não são suficientes para seus microsserviços”, ele chama atenção para algo que considero fundamental: em sistemas distribuídos, uma parte importante da complexidade deixa de estar dentro do código e passa a existir nas bordas — na comunicação entre serviços, na rede e nas integrações.
Nesse contexto, um teste unitário pode verificar perfeitamente uma pequena parte do sistema e ainda assim deixar de capturar problemas que aparecem quando as peças precisam conversar entre si.
Mas o ponto não é simplesmente trocar testes unitários por E2E.
Como o próprio Rafael coloca em outras discussões, testes se complementam. Para muitos sistemas, uma boa bateria de testes unitários e principalmente de integração pode ser suficiente.
E acho que essa é justamente a parte interessante da discussão.
Não deveríamos perguntar:
“Testes unitários ou testes E2E?”
Mas:
“Que tipo de evidência preciso para confiar que esse comportamento continua funcionando?”
Hoje, em um projeto bem modularizado, subir uma aplicação, banco e dependências em containers não é mais um problema tão grande.
Frameworks modernos também tornaram relativamente simples escrever e executar testes de API e E2E.
Então talvez a pergunta não devesse ser:
“Quantos testes unitários e quantos testes E2E devemos ter?”
Talvez a pergunta seja:
“Quais comportamentos do sistema precisam de mais confiança?”
E, depois disso:
“Qual é a forma mais adequada de obter essa confiança?”
Nem tudo precisa ser testado da mesma maneira
Gosto também da visão do Waldemar Neto sobre utilizar testes unitários para amarrar regras de negócio.
Isso faz bastante sentido.
Se tenho um motor de recorrência que recebe uma lista de ativos e decide quais pagamentos devem acontecer, por exemplo, existe pouco I/O e regras muito bem delimitadas.
Posso criar centenas de cenários.
Não preciso necessariamente subir banco, API, S3 ou qualquer outro serviço para descobrir se a regra:
“um ativo vencido não deve gerar um novo pagamento”
continua funcionando.
Um teste unitário consegue provar isso muito bem.
Agora imagine o caminho oposto.
Uma requisição entra na API, passa por autenticação, consulta o banco, chama um serviço externo, grava alguma coisa e eventualmente envia um arquivo para o S3.
Tentar representar cada pedaço desse fluxo com testes unitários pode produzir uma enorme quantidade de mocks e não mock muito…
Por que, assim diz a Bíblia:
Mock, and you shall be mocked.
Era pra ser engraçado, hehehe? Mas é uma pequena adaptação de Gálatas 6:7:
“Tudo o que o homem semear, isso também ceifará.”
O problema é que, quanto mais simulamos o comportamento das dependências, maior pode ficar a distância entre aquilo que nosso teste prova e aquilo que realmente acontece quando as peças se encontram.
Os mocks podem provar que nosso código funciona em relação aos mocks.
Mas não necessariamente que o sistema funciona em conjunto.
Nesse caso, um teste E2E ou um teste de API pode fornecer uma prova muito mais interessante.
Por isso, hoje gosto de pensar de uma forma bastante simples:
Muito I/O ou API → teste E2E.
Pouco I/O + regra bem definida → teste unitário.
Banco de dados, APIs externas, filas, S3 e outros serviços aumentam o valor de testar o comportamento integrado.
Regras de negócio, algoritmos, loops e transformações bem delimitadas tendem a ser excelentes candidatos para testes unitários.
Não porque um tipo de teste seja melhor que o outro.
Mas porque eles respondem perguntas diferentes.
Mas ainda falta uma coisa
Essa abordagem resolve o problema de como testar.
Ainda não resolve o problema de o que merece mais investimento em testes.
E foi aí que encontrei uma ideia que me fez pensar em uma outra possibilidade.
Arquitetura Medallion
Recentemente, enquanto desenvolvia um projeto relacionado à análise de dados, me deparei com o conceito de Medallion Architecture.
A ideia é organizar os dados em diferentes camadas — normalmente Bronze, Silver e Gold — conforme seu grau de transformação e qualidade.
Achei o conceito interessante.
E pensei:
e se fizéssemos algo parecido com testes?
Não estou propondo transportar o significado original dessas camadas para testes.
Estou usando a mesma ideia de camadas para organizar uma dimensão diferente:
a criticidade daquilo que estamos tentando proteger.
A partir daí, cheguei a uma proposta.
Test Confidence Architecture
A ideia é separar os comportamentos em camadas de criticidade.
Quanto mais importante for o comportamento para o negócio, maior deve ser a confiança exigida para modificá-lo.
Bronze, Silver e Gold não dizem como testar. Dizem quanto custa estar errado.
Bronze
É a camada de menor criticidade.
Aqui entram comportamentos simples, auxiliares e fluxos cujo impacto de uma regressão é relativamente baixo.
Por exemplo:
- validações simples;
- pequenas funções;
- transformações/helpers;
- contratos simples de API;
- comportamentos visuais pouco críticos.
Podem existir testes unitários, testes de API ou até testes E2E.
A camada não determina a técnica.
Ela determina o quanto aquele comportamento importa.
Silver
Aqui estão fluxos importantes para o produto, mas que podem ser isolados.
Por exemplo:
- uma aplicação específica;
- um fluxo relevante de API;
- uma operação que depende do banco;
- uma funcionalidade importante, mas que não representa uma regra central do negócio.
Silver representa comportamentos cujo risco pode ser coberto dentro de um contexto limitado do sistema.
Nesse caso, podemos testar o sistema como uma caixa-preta, isolando dependências externas quando necessário.
O objetivo é obter uma boa confiança no comportamento sem precisar reproduzir todo o ecossistema.
Gold
Aqui está o que não pode quebrar.
Regras essenciais do negócio.
Invariantes.
Comportamentos que, se estiverem errados, representam um problema real para o produto.
Nesse caso, vale investir em uma prova mais forte.
Pode ser um teste unitário.
Pode ser um teste de integração.
Pode ser um E2E completo.
Pode ser mais de um deles.
O ponto importante é:
Gold não significa E2E.
Gold significa alta criticidade.
Uma regra matemática extremamente importante pode ser Gold e ter centenas de testes unitários.
Um fluxo de pagamento pode ser Gold e exigir um E2E completo envolvendo aplicação, banco, serviço de pagamento e outros componentes.
A classificação é sobre o comportamento, não sobre o framework utilizado.
Como decidir a criticidade?
A classificação não deveria ser apenas uma etiqueta colocada arbitrariamente em cada teste.
Podemos começar com algumas perguntas simples.
O que acontece se isso estiver errado?
Uma falha visual pouco importante pode ser Bronze.
Uma falha funcional que afeta usuários pode ser Silver.
Uma falha que viola uma regra financeira ou de negócio pode ser Gold.
É possível corrigir depois sem impacto significativo?
Quanto maior o custo de descobrir o problema depois, maior a necessidade de confiança antes da mudança.
Esse comportamento representa uma regra que o negócio não pode violar?
Se sim, temos um forte candidato a Gold.
A ideia é gastar esforço de teste proporcionalmente ao custo de estar errado.
Duas dimensões, não uma
Até aqui temos uma dimensão:
1. Criticidade
O quanto precisamos confiar nesse comportamento?
Gold
Alta criticidade.
Invariantes críticos de negócio.
Exemplo: pagamento não pode ser duplicado.
Silver
Criticidade intermediária.
Fluxos importantes e isoláveis.
Exemplo: upload de um documento.
Bronze
Baixa criticidade.
Comportamentos de menor impacto.
Exemplo: validação auxiliar.
O invariante deveria ser escrito como uma regra de negócio, e não como o nome de um arquivo de teste.
Por exemplo:
“Um pagamento não pode ser processado duas vezes para a mesma cobrança.”
Isso é mais interessante do que:
should_not_duplicate_payment.spec.ts
O primeiro descreve o que o negócio exige.
O segundo descreve apenas como implementamos a verificação.
Uma segunda dimensão
Mas talvez ainda exista uma segunda dimensão.
Uma próxima coisa que quero explorar é o regime em que a propriedade é testada.
Podemos pensar, por exemplo, em testes determinísticos, fuzzy, adversariais e observacionais.
Ainda estou experimentando essa parte do modelo e prefiro não tentar fechá-la agora.
Quero entender melhor como essas dimensões se relacionam na prática antes de transformá-las em uma proposta mais completa.
Por enquanto, o que me interessa é a ideia de que criticidade e técnica não são a mesma coisa.
O que muda para uma startup?
Esse talvez seja o ponto mais importante da proposta.
Em uma startup, testar tudo profundamente é caro.
Mas não testar nada também é caro.
O problema é que normalmente tentamos resolver isso escolhendo uma distribuição fixa:
muitos unitários, alguns de integração e poucos E2E.
Só que o negócio não é distribuído dessa maneira.
Existem funcionalidades que podem quebrar sem grandes consequências.
E existem cinco linhas de código capazes de causar um problema enorme.
Por isso, talvez a estratégia de testes de uma startup devesse começar pelo risco.
Primeiro:
O que não pode quebrar?
Depois:
Qual propriedade precisa continuar verdadeira?
E só então:
Qual técnica e qual escopo vamos usar para obter essa evidência?
Isso permite gastar esforço de teste proporcionalmente ao custo de estar errado.
A pirâmide não precisa morrer
Não acho que a pirâmide de testes precise ser descartada.
Ela continua sendo uma boa forma de pensar sobre características dos testes: velocidade, isolamento, escopo e custo.
O que talvez esteja faltando é uma segunda camada de raciocínio.
A pirâmide responde:
Como estamos testando?
A arquitetura confiante responde:
O que estamos protegendo?
Talvez uma estratégia moderna de testes não devesse ser representada por uma única forma.
Talvez o objetivo não seja ter mais testes.
Seja ter mais confiança onde ela realmente importa.
Esse é o modelo que quero explorar melhor.
Em breve quero adicionar novas dimensões a essa ideia e experimentar como elas funcionam em projetos reais.
E provavelmente ainda tem muita coisa para quebrar.
Comentários sobre trechos que mudaram
O texto foi editado depois destes comentários, e a frase original não existe mais.